最近、「最新の生成AI(LLM)を使えば、どんな仕事も自動化できる」「従来のAI技術はすべてLLMに置き換わる」といった話を聞く機会が増えていないでしょうか。自社サービスへのAI導入や、業務効率化のために大規模言語モデル(LLM)の活用を検討されている方も多いはずです。
しかし、2025年に大きな話題となったある研究が、この「LLM万能論」に一石を投じました。それは、**「10年前に開発された画像認識AIモデル(CNN:畳み込みニューラルネットワーク)が、皮膚がんの診断タスクにおいて最先端のLLMを上回る精度を出した」**というニュースです。
「技術の進歩が激しいAIの世界で、なぜ10年前の技術が最新のLLMに勝てるのか?」と不思議に思われるかもしれません。
実はこの事例には、単なる医療AIの比較にとどまらず、私たちが実務で**「プロンプトエンジニアリング」**を活用し、AIシステムを設計・運用するうえで極めて重要な示唆が含まれています。
本記事では、この研究の背景を分かりやすく紐解きながら、最新LLMと専門AIモデルの決定的な違い、そして実務で成果を出すためのプロンプトエンジニアリングの導入・設計・運用ガイドを詳しく解説します。
なぜ「10年前のAI」が最新LLMに勝てたのか?技術の仕組みと背景
まずは、なぜこのような逆転現象が起きたのか、専門用語を噛み砕きながら解説します。
専門モデル「CNN」と汎用モデル「LLM」の違い
今回の検証で登場する CNN(Convolutional Neural Network:畳み込みニューラルネットワーク) は、画像認識に特化したAIの仕組み(アルゴリズム)です。今から約10年前の2010年代半ば、ディープラーニング(深層学習)が世界的なブームとなった際に、画像分類の分野で飛躍的な精度向上をもたらしました。
一方で、現在主流となっている LLM(Large Language Model:大規模言語モデル) や、画像とテキストを同時に扱える マルチモーダルLLM は、文章の理解や文脈の把握、広範な知識を使った推論に特化した「汎用的なAI」です。
両者の違いを人間に例えるなら、以下のようになります。
- CNN(10年前のモデル):皮膚病変の画像だけを何万枚も観察し続けてきた「画像診断専門の職人」
- 最新LLM(マルチモーダルモデル):あらゆるジャンルの本を読み、文章も画像も扱える「超高学歴なゼネラリスト」
皮膚がんの診断という「極めて高度で専門的な視覚的パターンの識別」が求められるタスクにおいて、汎用的な知識を持つ最新LLMよりも、特定の画像識別だけに特化して訓練されたCNNの方が優れた精度を発揮したのです。
画像入力における「指示(プロンプト)」の限界
画像に対応した最新のLLMを使う場合、私たちは通常、テキストでプロンプト(指示文)を入力します。
例:「添付した皮膚の画像を分析し、悪性腫瘍の可能性がどのくらいあるか診断してください」
しかし、どれほどプロンプトエンジニアリングを工夫して丁寧な指示を与えたとしても、LLMが画像を処理する内部メカニズム(画像を細かな領域に分割して数値化する仕組み)と、専門のCNNが画像をピクセル単位で微小な特徴まで捉えるメカニズムには構造的な違いが存在します。
プロンプトによってAIの「考え方」や「回答のフォーマット」を制御することはできても、AIが「画像を読み取る解像度や認識能力そのもの」をプロンプトだけで引き上げるには限界がある、という現実を示しています。
(※なお、一次情報元である記事・論文における具体的な実験対象モデルのバージョンや、詳細なハイパーパラメータ等の条件については一部「未確認」な事項が含まれるため、実際の導入時には個別での評価が必要です)
成果を出すための「プロンプトエンジニアリング」実務導入・設計・運用ガイド
「LLMが万能ではないなら、プロンプトエンジニアリングは意味がないのか?」というと、決してそうではありません。むしろ、「どのタスクをLLM(プロンプト)に任せ、どのタスクを専用AIや従来型プログラムに任せるか」を正しく設計することこそが、現代のプロンプトエンジニアリングの本質です。
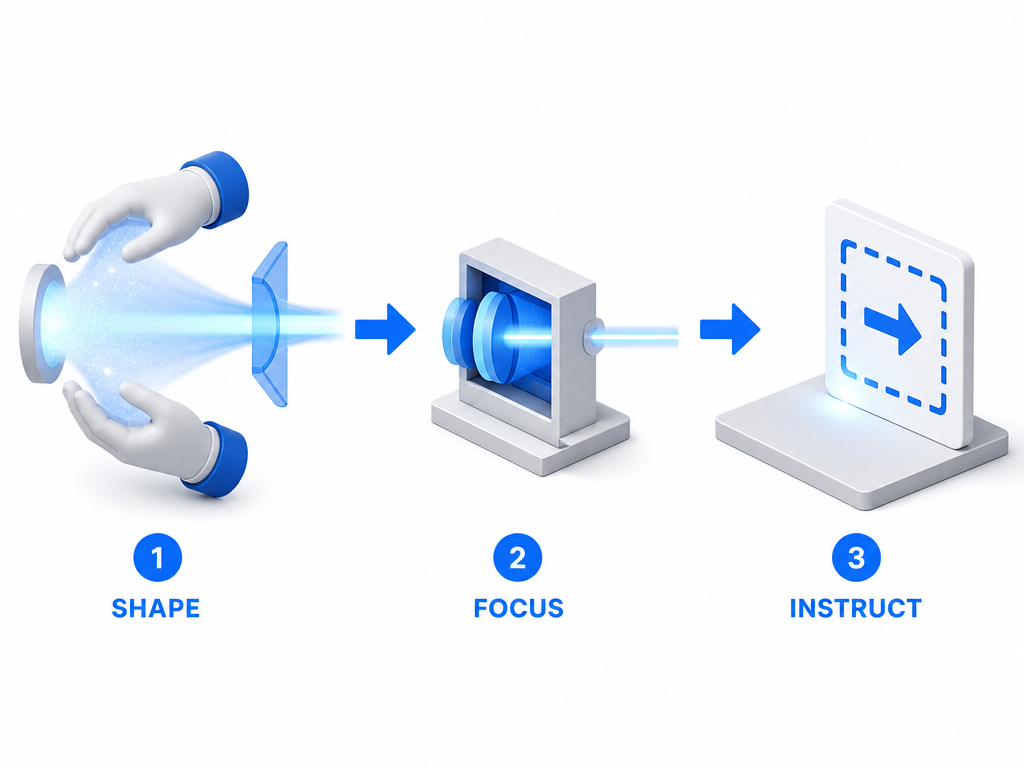
ここからは、実務で失敗しないためのプロンプトエンジニアリングの導入・設計・運用プロセスを3つのフェーズに分けて解説します。
フェーズ1:【導入】タスクの分解と「切り分け」の設計
AIを活用したシステムを作る際、最初に行うべきは「すべてをLLM+プロンプトで解決しようとしないこと」です。
1. 専門処理と汎用処理の分離
- 専門的な処理(画像認識・数値予測・高速な検索など):専用の軽量モデルや従来のアルゴリズムを活用する
- 言語的処理(要約・分類・文脈判断・対話・フォーマット変換など):LLMとプロンプトエンジニアリングを活用する
例えば、今回の皮膚がん診断の例をシステムに落とし込むなら、次のようなハイブリッド構成が最適解となります。
- ユーザーが提出した画像を、高精度な 画像専用モデル(CNN等) に読み込ませ、識別スコア(例:悪性確率 85%)を出力する。
- その数値データと患者の問診票テキストを LLM に渡す。
- プロンプト を使って「専門モデルの分析結果と問診票に基づき、患者向けに分かりやすい説明文章を生成する」という指示を出す。
このように、得意分野ごとに役割を分担させることが、精度と安定性を両立するプロンプトエンジニアリングの第一歩です。
フェーズ2:【設計】マルチモーダルプロンプトの設計原則
画像とテキストを組み合わせた入力を行う場合、テキスト単体のプロンプトとは異なる設計ノウハウが必要です。
1. 役割(Role)とコンテキスト(文脈)の明確化
AIに対してどのような立場で画像を分析すべきかを明記します。
|
|
2. 「見落とし」を防ぐための構造化プロンプト(Chain of Thought)
画像だけを渡して「判定してください」と頼むと、LLMは全体的な雰囲気で回答してしまい、ハルシネーション(もっともらしい嘘)を引き起こしやすくなります。観察すべき視点をプロンプト側で構造化してあげることが重要です。
|
|
このように、人間の専門家がチェックする手順をプロンプト内で指示することで、分析の抜け漏れを防ぎ、精度の向上が期待できます。
フェーズ3:【運用】継続的な評価とプロンプトチューニング
プロンプトエンジニアリングは、「一度作って終わり」ではありません。システム運用が始まった後も、継続的な精度管理が必要です。
1. ゴールデンデータセット(テスト集)の作成
「どのようなプロンプトが最も良い成果を出すか」を客観的に判断するために、あらかじめ「正解データ」を数件〜数十件用意しておきます。
2. 評価指標の設定
テキスト出力の品質評価には、以下の視点を取り入れます。
- 事実の正確性:専門モデルの出力や元データと矛盾していないか
- フォーマットの遵守度:指定したJSON形式や箇条書きに従っているか
- 安全・倫理面:断定的な誤診リスクのある表現をしていないか
プロンプトを変更した際は、必ずこのテスト集に対して一括で入力を流し、以前のプロンプトよりも精度が向上しているかを数値で比較・検証します。
実務でハマりやすい落とし穴と注意点
最新技術とプロンプトエンジニアリングを組み合わせる際、特に注意すべき3つの落とし穴があります。
1. 「最新のLLMだから正しい」というバイアス
話題のモデルや新しいバージョンが登場すると、「これを使えば今までの課題がすべて解決するはずだ」と思いがちです。しかし、今回の皮膚がん診断の例が示す通り、最新=すべてのタスクで最高精度ではありません。 業務要件(精度、速度、コスト)によっては、従来の機械学習モデルや小さな専門モデルの方が遥かに優れているケースが存在します。
2. コストとレスポンス速度の視点欠如
巨大なマルチモーダルLLMに高解像度の画像を大量に読み込ませて処理する場合、1回の呼び出しにかかるAPI費用が高額になり、応答スピードも遅くなります。一方で、CNNのような専用モデルは、自社サーバーやエッジデバイス上で数ミリ秒かつ低コストで動作させることが可能です。 プロンプトエンジニアリングによる解決を図る前に、「そのシステムのリレータイムやランニングコストは許容範囲内か」 を必ず試算しましょう。
3. 一次情報・検証条件に関する注意事項
本記事の元となった海外の議論や記事においては、「10年前のCNN」と「最新LLM」の比較実験が行われていますが、実験で用いられたデータセットの偏りや、比較対象となったLLMの具体的なプロンプト内容、ハイパーパラメータの設定など、一次情報内で詳細が完全に明記されていない「未確認」の事項も含まれています。 実務で同様の仕組みを導入する際は、必ず自社のデータを用いてベンチマーク(比較テスト)を行うようにしてください。
まとめ:AI時代に求められる「技術の適材適所」とプロンプトの役割
10年前の画像認識AIが最新LLMに勝ったというニュースは、AIに関わるすべての人々にとって重要な学びを与えてくれます。
- AIは万能ではない:どんなに巨大なLLMであっても、特定領域に特化した専門モデルに及ばない場面がある。
- プロンプトエンジニアリングの本当の役割:単にAIにお願い文章を書くことではなく、「LLMが得意なこと・苦手なこと」を理解し、システム全体の中で最適な指示を与えることである。
- 適材適所のアーキテクチャ:画像認識は専用モデル(CNN等)に任せ、解釈や要約、会話インターフェースをLLM(プロンプト)で構築する「ハイブリッド構成」が実務における強固な最適解となる。
「流行りのLLMをどう使うか」から思考をスタートするのではなく、「自分たちが解決したい課題に対して、どの技術をどう組み合わせるのが最善か」 という視点を持つこと。それこそが、これからのAI活用・プロダクト開発で成果を出し続けるための最も重要なプロンプトエンジニアリングの極意です。