日常のデータ分析業務において、「必要なデータを揃えるだけで時間がかかる」「抽出したデータを整形し、グラフ化してチームに共有する作業が面倒」だと感じたことはありませんか。専門的なデータ分析ツールやプログラミング言語を使えるエンジニアと、現場のビジネス担当者の間には、どうしても作業や意思疎通の壁が存在します。
こうしたデータ業務における分断や手間の課題を解決する手段として、近年急速に注目を集めているのが「AIエージェント」という考え方です。AIエージェントとは、人間が毎回細かく指示を出さなくても、与えられた目標を達成するために自律的に考え、データ処理やプログラムの実行などの作業を代行してくれる賢いAIのことです。
本記事では、データチーム向けに開発されたオープンソース(誰でも自由に利用や改良ができるようにソースコードが公開されているソフトウェア)のAIエージェント協調型ワークスペース「Databench by Alkera」を題材に、AIエージェントをデータ分析の現場へ導入・設計・運用するための実践的なアプローチをわかりやすく解説します。
データ分析の現場が抱える課題とAIエージェントの必要性
データ業務における「分断」と作業負荷
多くの企業において、データ分析の現場では以下のようなお悩みがよく聞かれます。
- ツールの行き来が激しい: データベースからデータを抽出するツール、データを加工するプログラム、分析結果をビジュアル化するダッシュボードツールなど、複数の画面を行き来しなければならない。
- 専門人材への作業集中: SQL(データベースを操作するための言語)やPython(データ処理が得意なプログラミング言語)が書けるデータエンジニアに作業依頼が集中し、分析結果が出るまでに時間がかかる。
- チーム内共有の手間: 分析した結果をスライドやチャットツールに貼り付けて共有する際に、文脈や前提条件が抜け落ちてしまう。
これまでは、分析作業を自動化するためにプログラムを組む必要がありましたが、仕様変更やデータの形式が変わるたびに修正が必要になり、管理の負担(運用コスト)が課題となっていました。
AIエージェントとは?従来の自動化ツールとの違い
ここで活躍するのが「AIエージェント」です。従来の自動化ツール(RPAや定型スクリプトなど)は、「あらかじめ決められた手順通りに動く」ことしかできませんでした。そのため、データに予期せぬ例外が含まれていたり、指示が曖昧だったりするとエラーで止まってしまいます。
一方、AIエージェントは以下のような特徴を持っています。
- 自律的な思考能力: 「今月の売上データの傾向を分析して」という大まかなゴールを与えると、必要な手順(データの取得、クリーニング、グラフ作成、考察の整理)を自分で考えて実行します。
- 状況に応じた修正: 作業途中でエラーが発生した場合、AI自らが原因を推論し、プログラムを修正して再実行します。
- 対話型の協調: 人間と会話をしながら、不足している情報を質問してきたり、途中の結果を見せてフィードバックを求めたりします。
このように、AIエージェントは単なる「自動化ツール」を超えて、データ分析チームの「新しいメンバー」として一緒に働く存在になりつつあります。
「Databench by Alkera」とはどのようなプロダクトか?
チームのための協調型エージェントワークスペース
プロダクト情報によると、「Databench by Alkera」は「データチーム向けオープンソース協調型エージェントワークスペース(Open-source collaborative agentic workspace for data teams)」として提供されています。
言葉を分解して理解してみましょう。
- オープンソース(Open-source): プログラムの設計図が公開されており、自社の環境に構築したり、自社向けに機能を拡張したりすることが可能です。
- 協調型(Collaborative): AIエージェントと人間、あるいは複数の人間同士が同じ作業空間でリアルタイムに協力し合える仕組みを持っています。
- エージェント型ワークスペース(Agentic Workspace): AIエージェントが作業の主軸となり、データ処理や分析の実行を担う統合されたデジタル作業環境です。
なぜオープンソースのワークスペースが注目されるのか
企業が扱うデータには、顧客の個人情報や自社の機密情報が含まれることが多くあります。クラウド上の標準的なAIサービスにデータをそのまま送信することに抵抗がある企業も少なくありません。
Databenchのようにオープンソースとして提供されるツールは、自社が管理するサーバーやクラウド環境内にシステムを構築しやすいため、セキュリティやガバナンス(データの管理規則)を維持しながら最新のAIエージェント技術を導入できるというメリットがあります。
なお、Databench by Alkeraの具体的な画面レイアウトや内部の技術的仕様、詳細な機能一覧についての一次情報(プロダクトページ)記載は限定的であり、現時点での詳細な内部構造や推奨動作環境は「未確認」です。ですが、データチーム向けエージェントワークスペースとしてのコンセプトは、現代のデータ分析現場のニーズに非常に合致しています。
AIエージェントを実務に組み込むための導入・設計ガイド
DatabenchをはじめとするAIエージェントツールを、実際の業務(実務)に導入していくためには、適切なステップを踏む必要があります。単にツールを導入するだけでは、「思ったような回答が返ってこない」「使い道がわからない」といった状態になりがちです。
以下に、AIエージェントをデータ業務に組み込むための実践的な設計手法をまとめました。
ステップ1: 役割と権限の設計(AIにどこまで任せるか)
AIエージェントを導入する際、最初に決めるべきは「AIエージェントの役割」と「アクセス権限」です。
- 閲覧権限の限定: AIがアクセスできるデータベースを、読み取り専用(Read-Only)の領域や、匿名化されたデータセットに限定します。元データを書き換えたり削除したりする権限を与えるのは避けるのが安全です。
- 人間の承認(Human-in-the-loop): AIエージェントが自律的に作業を進める場合でも、「実行前のSQL文の確認」や「最終レポートの出力前」など、要所で人間が内容をチェックして許可を出す仕組みを組み込みます。
ステップ2: 対話型ワークフローの設計
データを分析する際、人間とAIエージェントがどのようにやり取りをするかを設計します。
- 目的の入力(プロンプト): ユーザーが「過去3ヶ月間の製品別リピート率の推移を知りたい」と自然な言葉で入力します。
- 計画の提示: AIエージェントが「どのテーブルからデータを取得し、どう集計するか」の計画(思考プロセス)を人間に提示します。
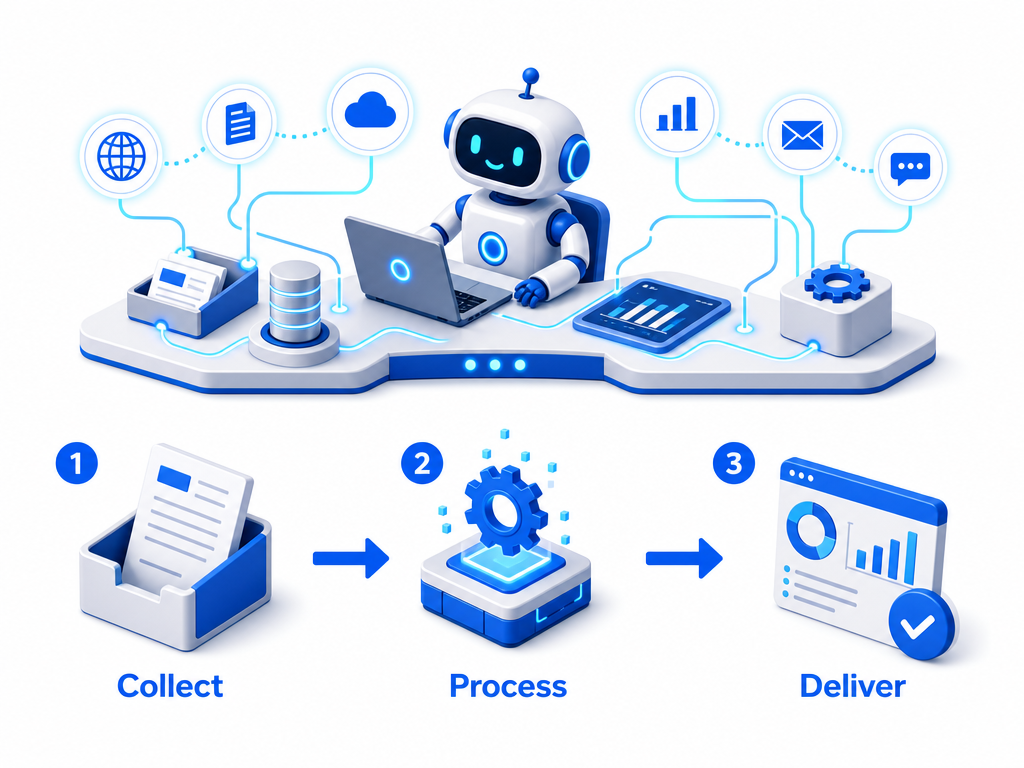
- データの抽出と加工: 承認された計画に基づき、AIがクエリ(データ抽出コマンド)を生成して実行します。
- 可視化と考察: 得られたデータをグラフ化し、簡易的な考察テキストを添えてワークスペース上に表示します。
このように、作業のプロセスを透明化し、人間が追跡できるように設計することが、AIエージェントを信頼して運用するためのキーポイントです。
ステップ3: チームでのコラボレーション(協調)設計
Databenchのような協調型(Collaborative)ツールでは、AIが生成した分析結果や途中経過を、チームメンバー全員で共有・ディスカッションできる環境を作ることが大切です。
例えば、AIエージェントが作成したグラフに対して、ビジネス担当者がコメントをつけ、「この異常値の部分について追加で分析して」と追記指示を出せるような運用フローを確立します。これにより、データ分析の「作業」と「意思決定のための議論」が同じ場所で行えるようになります。
AIエージェントの運用ガイド:現場で直面する注意点と対策
AIエージェントは非常に強力なツールですが、実務で運用する際にはいくつかの注意点や壁が存在します。導入後に後悔しないための主な対策を確認しておきましょう。
1. 幻覚(ハルシネーション)への対策
AI(特に大型言語モデル)は、もっともらしい嘘や誤った情報を出力してしまう現象(ハルシネーション/幻覚)を起こすことがあります。データ分析において誤った数値を鵜呑みにすることは、ビジネス上の重大な判断ミスにつながります。
- 対策: AIエージェントが使用した「データソース(どのテーブルのどのカラムを見たか)」や「実行した計算プログラム(SQLやPythonコード)」を必ず画面上に表示させ、人間が検証できるようにします。数字そのものを鵜呑みにせず、集計ロジックが正しいかをチェックする習慣をつけることが重要です。
2. データガバナンスとセキュリティ
オープンソースで構築する場合であっても、AIエージェントを経由した漏洩リスクには注意が必要です。
- 対策: 社内の情報セキュリティ部門と連携し、AIモデルへ送信されるデータに機密情報が含まれていないか、またモデルの学習に使われない設定(API利用時のデータ利用規約の確認など)になっているかをチェックします。
3. コストとレスポンス速度の管理
AIエージェントは、目標を達成するためにバックグラウンドで何回もAIモデルとの通信(API呼び出し)を行うことがあります。そのため、複雑な指示を一度に出すと、処理に時間がかかったり、APIの利用料金が高額になったりするリスクがあります。
- 対策: 一度に与えるタスクの範囲を限定する、もしくは1回のタスクで実行できる処理の上限回数を設定するなどのガードレール(安全装置)を設けることが推奨されます。
4. 未確認事項の検証(Databench導入時のアドバイス)
Alkeraが提供するDatabenchは比較的新しい取り組みであり、公式ドキュメントやコミュニティによる具体的なサポート範囲、既存システム(SnowflakeやBigQuery、Databricksなどのデータ基盤)との接続プラグインの充実度については、事前によく検証する必要があります。
導入を検討する際は、いきなり全社の基幹データに接続するのではなく、まずは一部のテスト用データ環境でポック(PoC:概念実証。実際に動かして実現可能性を確かめること)を行い、自社のワークフローに適合するかを確認することをお勧めします。
まとめ:AIエージェントと共に進化するこれからのデータ分析チーム
本記事では、「Databench by Alkera」をテーマに、データチーム向けAIエージェントの基本概念から、導入・設計・運用のポイントまでを整理してご紹介しました。
改めて重要なポイントを振り返ります。
- AIエージェントは単なる自動化ツールではない: 指示された目的のために自律的に考え、試行錯誤しながらデータ処理を行う協調パートナーです。
- Databenchの強み: オープンソースであり、データチームが協調してAIエージェントを活用するための統合ワークスペースを目指しています。
- 導入の要点: 人間の承認プロセス(Human-in-the-loop)を組み込み、データガバナンスやハルシネーション対策を意識した設計が欠かせません。
AIエージェントを活用することで、データエンジニアは繰り返し発生する定型クエリの作成から解放され、より高度なデータ基盤の構築やアーキテクチャ設計に集中できるようになります。また、ビジネス担当者は自らAIと対話しながら素早く必要なデータへアクセスできるようになります。
AIエージェントを「人間の仕事を奪うもの」として捉えるのではなく、「データ分析の生産性を何倍にも引き上げる協同作業者」としてチームに迎え入れる準備を、今から始めてみてはください。