「ChatGPTなどのAIに簡単な集計作業とレポート文作成をお願いしたら、計算結果や日本語の数値表現がおかしくなってしまった……」
業務で大規模言語モデル(LLM:大量のテキストデータを学習した人工知能モデル)を活用しようとした際、このような経験をしたことはないでしょうか。人間からすれば「足し算をして、その結果を言葉(文字)で書くだけ」という非常にシンプルな作業に見えます。しかし、最先端のAIであっても、桁数が大きくなるとこのシンプルな指示で途端に間違いを犯しやすくなることが分かっています。
この記事では、技術者のColin Frasier氏がGPT-4o等を用いて行った「足し算の答えを言葉で返させる(addition in words)」実験や、Simon Willison氏によるQwen 3.8 27Bに関する考察を題材にします。AIがなぜこのような基本作業でつまづくのかという構造的な理由を解き明かしながら、実務でAIの精度を高めるための「プロンプトエンジニアリング(AIへの最適な指示文設計)」の導入・設計・運用ノウハウを分かりやすく解説します。
導入:なぜAIは「計算結果を言葉で答える」だけで失敗するのか?
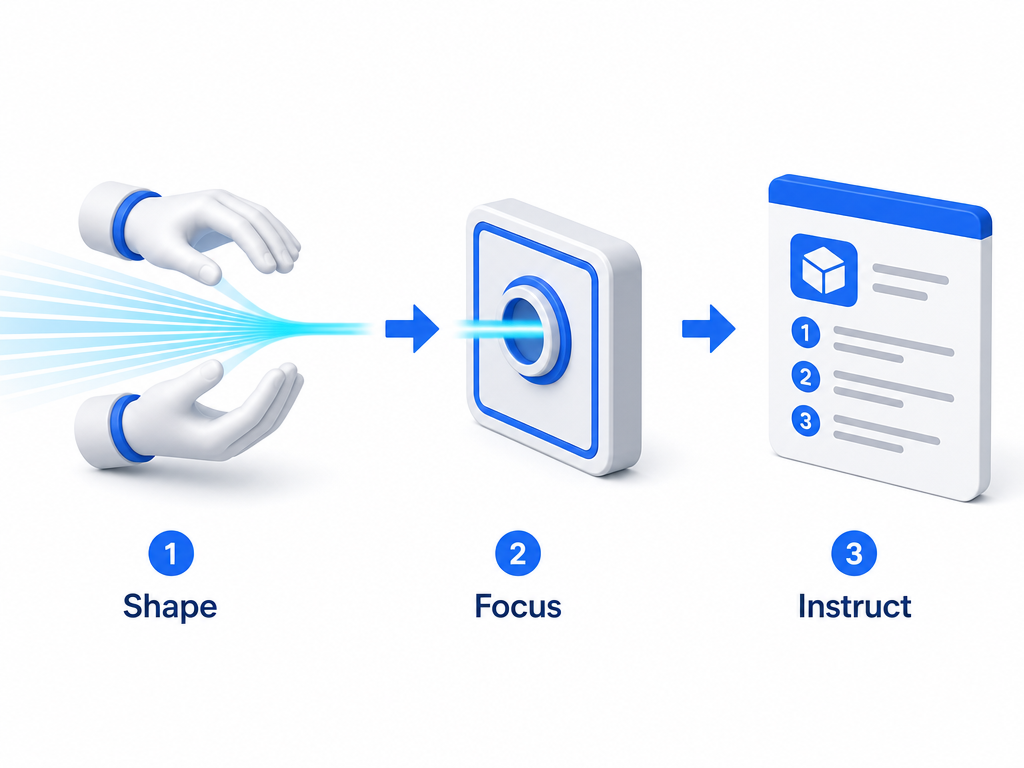
私たちは普段、無意識のうちに「数字の計算」と「それを言語で表現すること」を区別して行っています。たとえば「123 + 456」という計算をするとき、まず「579」という数値を出し、その後に「五百七十九(あるいは five hundred seventy-nine)」という言葉に変換します。
しかし、指示文(プロンプト)の出し方によっては、AIにこれらを一気に実行させようとしてしまいます。AIに対して「大きな桁の足し算をして、その結果を数字ではなく『言葉』で直接答えなさい」と指示すると、どんなに優秀なモデルでも急激に正解率が下がってしまうのです。
これは単なる一例に過ぎませんが、実務においてもまったく同じ問題が発生します。たとえば「売上データを集計して、傾向を自然な日本語の文章で報告して」と指示したとき、集計値そのものがズレたり、文章内の数字の単位がおかしくなったりする現象の根っこには、この「計算と文章化の同時処理」による負荷が存在しています。
業務でAIを安定して活用するためには、AIの得意・不得意を理解し、適切な指示の組み立て方(プロンプトエンジニアリング)をマスターすることが欠かせません。
事例で学ぶ「Addition in Words」実験とLLMの構造的課題
Colin Frasier氏の実験とSimon Willison氏の考察
技術者のColin Frasier氏は、GPT-4oなどの高性能な言語モデルに対して「桁数が大きくなる数字同士の足し算を行い、その結果を数字ではなく言葉(言葉による数値表現)で返す」という実験(Addition in Words)を行いました。
この実験では、以下のような挙動が観察されています。
- 小さな桁数(例: 2桁や3桁の足し算)であれば、AIは問題なく「言葉」で正しい合計値を返すことができる。
- 桁数が大きくなる(例: 5桁、6桁以上)につれて、急激に間違った結果を出力する確率が高まる。
Simon Willison氏のブログ記事では、この実験結果を取り上げつつ、オープンなAIモデルである「Qwen 3.8 27B」などにおける挙動や、モデルが計算と言語変換を同時に行う際の内部的な難しさについて言及しています。(※なお、本実験における具体的なパラメータ構成や詳細な全テストデータ等、一次情報記事に直接記載のない細かな条件については「未確認」となります。)
AIが「数字を言葉で扱う」のを苦手とする3つの理由
なぜ、最新のAIでもこのような簡単な作業で失敗してしまうのでしょうか。理由は大きく分けて3つあります。
1. トークナイズ(テキストの小分け化)の仕組み
AIは人間のように文字列を直接読んでいるのではなく、「トークン」と呼ばれる細かな記号や単語の破片に分解して処理しています。「12345」という数字が、AIの内部では「12」「345」のように不自然に分割されて認識されることがあります。この「文字の小分けのされ方」が、桁数や計算処理の邪魔をしてしまうのです。
2. 計算処理とテキスト予測の混同
大規模言語モデルは基本的には「次に続く確率が高い言葉を予想して出力する」仕組みで動いています。純粋な数学的計算を行っているわけし、「この文脈なら次はこの単語が来るだろう」という確率計算をしているため、複雑な計算を文字として直接出力しようとすると、計算のロジックが途中で破綻しやすくなります。
3. 途中経過(思考のステップ)の欠如
人間であっても、暗算で大きな数字の足し算を行い、それをいきなり言葉で発声しようとすれば間違えてしまいます。紙にひっ算を書いたり、途中の数値をメモしたりする「思考の過程」が挟まらないため、AIも同様に処理パンクを起こしてしまうのです。
実務で使えるプロンプトエンジニアリング実践ガイド:導入・設計・運用
以上の課題を踏まえ、業務システムや日常業務にAIを組み込む際、どのようにプロンプトエンジニアリングを設計・運用すればよいのか、具体的に解説します。
1. 設計原則:「思考のプロセス」と「最終出力」を分離する
AIに正確な答えを出させるための最も基本的かつ強力なテクニックは、AIに「段階を踏んで考えさせる」ことです。専門用語では「Chain of Thought(思考の連鎖)」などと呼ばれますが、平易に言えば「途中の考え方を書き出させること」です。
悪い指示の例(一括処理)
以下の2つの数値の合計を計算し、その結果を日本語の文字で出力してください。 数値A: 45,820 数値B: 38,190
このように一度に結果だけを求めると、間違った数値を言葉にしてしまうリスクが高まります。
改善された指示の例(段階的処理)
以下の手順に従って、順を追って処理してください。
ステップ1: 数値Aと数値Bを、まず数字のまま正確に足し算してください。 ステップ2: 計算結果の数字を「10,000の位」「1,000の位」などに分解して確認してください。 ステップ3: 確認した数値をもとに、最終的な結果を日本語の言葉(例:八万四千一0)に変換して出力してください。
出力フォーマット: 思考過程:[ここにステップ1〜2を記述] 最終回答:[ここにステップ3の言葉を出力]
このように指示することで、AIは内部的に正しい計算を行ってから言葉への変換作業に入るため、精度が劇的に向上します。
2. タスクの分割(マルチステップ・プロンプト)
プロンプトエンジニアリングの設計において、ひとつの指示文にすべての命令を詰め込む必要はありません。複雑な業務では、以下のようにシステム的に役割を分けることが推奨されます。
- 計算・集計専門プロンプト:まずデータを数字のまま正確に集計・計算させる。
- 検証プロンプト:計算結果の桁数や形式に間違いがないかチェックさせる。
- 文章化専門プロンプト:正確に計算された数字データをもとに、人間が読みやすい報告文を作成させる。
このように処理を段階(パイプライン)として分けることで、どこでエラーが発生したかが明確になり、運用時のメンテナンスも極めて容易になります。
3. 実務運用のためのプロンプト運用サイクル
プロンプトエンジニアリングは「一度書いて終わり」ではありません。システム構築と運用においては、以下のサイクルを回すことが成功の秘訣です。
ステップ1:プロンプトのテンプレート化
指示文を固定の「型(テンプレート)」として定義し、入力データのみを差し替えられるように設計します。
ステップ2:自動テスト・評価体制の構築
想定される様々な入力パターン(小さい数字、巨大な数字、例外的なデータなど)を用意し、プロンプトを変更した際に精度が落ちていないかを自動で検証する仕組みを作ります。
ステップ3:出力ログの監視と修正
実際の運用で発生した「間違った出力事例(コーナーケース)」を定期的に収集します。失敗した事例をもとに、指示文の「制約事項」や「注意書き」を補強していくことで、プロンプトの堅牢性を高めていきます。
実務導入における注意点と限界:LLMに頼りすぎないシステム設計
プロンプトエンジニアリングによってAIの回答精度を大幅に向上させることは可能ですが、AIの特性に由来する限界や注意点も存在します。
1. 純粋な計算機能は外部ツール(プログラム)に任せる
大規模言語モデルに複雑な計算を「暗算」させること自体が、本来はAIの得意分野ではありません。実務で極めて高い計算精度(100%の正解率)が求められる場合は、プロンプトだけで解決しようとせず、Pythonなどの計算プログラムを呼び出す仕組み(Code Interpreterやツール連携機能)を組み合わせるのが鉄則です。
- AIの役割:人間の指示を解釈し、「どの計算プログラムを実行すべきか」を判断する。
- プログラムの役割:実際の計算を正確(100%の精度)に行う。
- AIの役割(再):計算結果を受け取り、読みやすい文章やレポートに整形する。
このように役割分担させる設計を行うことで、AIの弱点を補うことができます。
2. モデルのバージョンアップや種類による挙動の変化
GPT-4oやQwen 3.8 27Bのように、AIモデルの種類やサイズによって、同じプロンプトを入力しても得られる結果の精度や表現パターンは異なります。また、モデルのアップデートによって突然プロンプトの効き目が変わることもあります。
実務においては、「特定モデルの癖に依存しすぎた極端なプロンプト」を作るのではなく、構造的で論理的な指示文を心がけ、モデル変更時にも再テストができる環境を整えておくことが重要です。
3. 未確認事項の扱いと運用上のリスク管理
AIの内部メカニズムや、各モデルが特定の実験で示した細かい挙動のすべてが論文や公式ドキュメントで開示されているわけではありません(本記事で取り上げた実験の非公開データ等も「未確認」の領域です)。そのため、実務システムへの導入時は「AIは原理的に間違える可能性がある」という前提(前提としての不確実性)に立ち、重要なデータ出力には人間の確認ステップ(Human-in-the-Loop)を挟む業務プロセス設計を行いましょう。
まとめ:LLMの特性を理解したプロンプト設計が成功の鍵
Qwen 3.8 27BやGPT-4oを巡る「Addition in Words(言葉による足し算)」の実験は、AIが一見シンプルに見える作業でどのような壁に突き当たるのかを象徴的に示しています。
実務でプロンプトエンジニアリングを導入・設計・運用する際の要点を改めて整理します。
- AIの不得意を理解する:計算と文章化を同時に行わせると精度が低下する。
- 思考プロセスを分離する:「順を追って計算してから文章化する」指示文を作る。
- タスクを細分化する:1つのプロンプトに詰め込まず、ステップ分けして処理する。
- プログラムと連携する:厳密な数値計算はプログラムに任せ、AIは文脈理解と文章化に集中させる。
- 継続的な検証と運用:テストケースを作成し、ログを監視しながらプロンプトを育てていく。
AIに適切な「指示の出し方」を設計することは、人間でいう「分かりやすい業務指示書」を作る作業と非常によく似ています。AIの構造的な仕組みや得意・不得意を正しく理解し、適切なプロンプトエンジニアリングを実践することで、業務の自動化や効率化を安全かつ効果的に進めていきましょう。