はじめに:AIチャットボット導入で直面する「運用の壁」
近年、ChatGPTをはじめとする大規模言語モデル(LLM)の発展に伴い、多くの企業が社内システムや顧客向けサービスにAIを組み込む試みを進めています。しかし、実際にプロジェクトを動かしてみると、次のような壁に突き当たることが少なくありません。
- 「一問一答のチャットボットはできたが、社内データベースを検索して適切な処理まで自動で行うような、複雑な業務には対応できない」
- 「便利だと言われるAIフレームワーク(LangChainやLlamaIndexなど)を使って作ってみたが、内部の挙動がブラックボックス化していて、エラーが発生したときの原因特定ができない」
- 「ライブラリのバージョンアップが頻繁で、既存のコードがすぐに動かなくなってしまう」
このような課題を解決する鍵として注目を集めているのが、AIエージェントです。そして、その根本的な仕組みを理解するためのアプローチとして、既存のフレームワークに頼らず、純粋なPython言語(Pure Python)だけでゼロから構築して学ぶ手法が評価されています。
本記事では、GitHubで話題のオープンソース教材『ai-agents-zero-to-hero』のコンセプトを参考にしながら、AIエージェントの基礎概念から実務で使える設計・運用ガイドまでをわかりやすく解説します。専門的な用語も丁寧に言い換えながら説明しますので、AI開発の現場に携わる方はもちろん、これから業務効率化を目指すリーダーの方もぜひ「自分ごと」として参考にしてください。
AIエージェントとは?単なる「自動回答」との決定的な違い
まず、「AIエージェント」とは具体的にどのようなものを指すのでしょうか。
従来のAIチャットボット(一問一答型LLM)とAIエージェントの最大の違いは、**「自律的に考えて行動し、目標を達成できるかどうか」**にあります。
従来のチャットボットとAIエージェントの比較
| 項目 | 従来のAIチャットボット | AIエージェント |
|---|---|---|
| 動作の仕組み | 入力された文章に対して、記憶している知識から直接回答を作る | 目標を受け取り、必要な手順を自分で考えて実行する |
| 外部ツールの利用 | 基本的には行わない(知識の範囲内のみ) | 検索機能、計算機、データベース、APIなどを自発的に使用する |
| 処理の単位 | 1回のやりとり(一問一答) | 目的が達成されるまでの複数ステップのループ処理 |
| 役割のイメージ | 「質問に答える相談員」 | 「目的を聞いて調査・処理・報告までこなす実務担当者」 |
例えば、「明日の天気を調べて、社内チャットツールにリマインドを送って」という指示を出したとします。
従来のAIチャットボットの場合、「私はリアルタイムの天気予報を知りませんし、チャットツールに送信する機能もありません」と返答して終わってしまいます。
一方、AIエージェントの場合は、以下のように自分で考えて動きます。
- 思考: 「明日の天気を調べる必要がある。天気予報機能(ツール)を呼び出そう。」
- 実行: 天気予報APIにアクセスしてデータを取得する。
- 思考: 「天気が判明した。次に、社内チャットツールの送信機能を呼び出そう。」
- 実行: チャットツール連携を実行してメッセージを投稿する。
- 完了: 「リマインドの送信が完了しました」とユーザーに報告する。
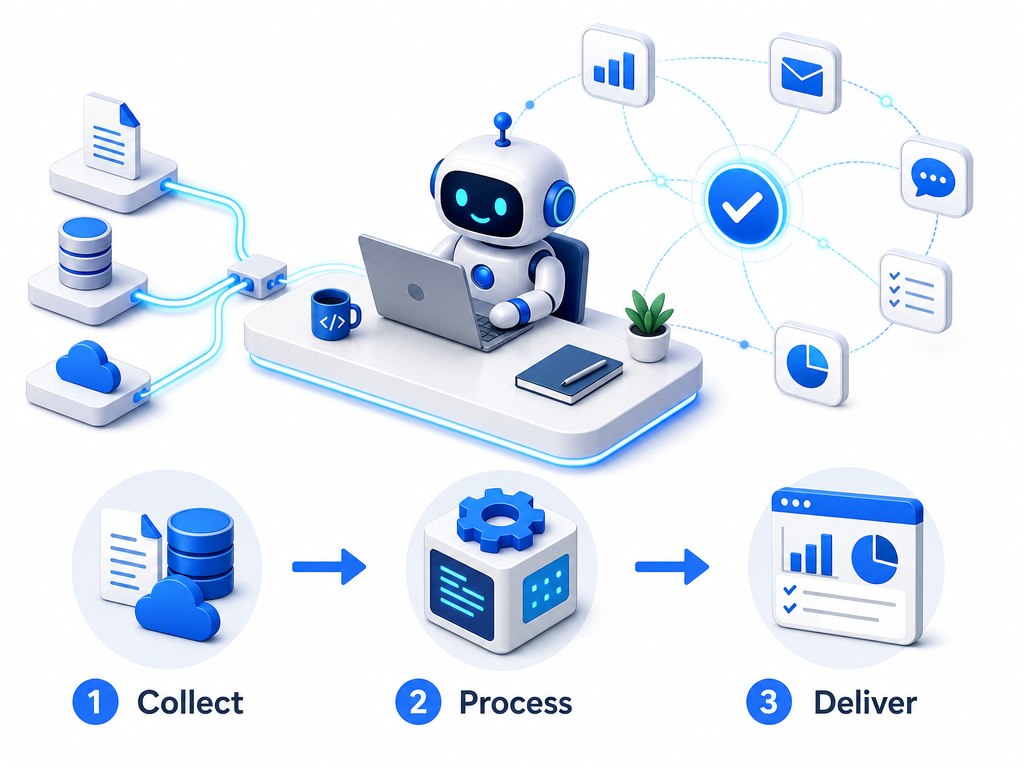
このように、**「目的の理解 → 計画立案 → ツールの選定と実行 → 結果の確認 → 完了判断」**という一連のサイクルを自動で回す仕組みが「AIエージェント」です。
なぜ「Pure Python」でゼロから学ぶべきなのか?
現在、AIエージェントを開発するための便利なライブラリやフレームワークが数多く存在します。これらを使えば、わずか数行のコードで高機能なエージェントを構築できるように見えます。
しかし、実務の現場では「便利さ」の裏に潜むリスクが存在します。
フレームワーク依存のリスク
- ブラックボックス化: 内部でどのような指示文(プロンプト)が生成され、どのようにエラーが処理されているかが見えにくく、不具合の調査が困難になります。
- 柔軟性の低下: 自社特有のセキュリティ要件や複雑な業務ルールを組み込もうとした際、フレームワークの制約に阻まれることがあります。
- 保守性の低下: 開発が活発なライブラリほど、仕様変更が頻繁に起こり、システムの安定稼働を阻害する原因となります。
GitHubで公開されたリポジトリ『ai-agents-zero-to-hero』は、まさにこの問題に対する回答として提示されています。サードパーティの特殊なライブラリを使わず、標準的なPython(Pure Python)だけでAIエージェントをコード化することにより、内部構造や仕組みを「素の知識」として身につけることを目的としています。
(※なお、該当リポジトリに含まれる個別のソースコード詳細や最新のコミット状況については未確認です。そのため、本記事では一般的なPure PythonによるAIエージェント構築の理論と設計パターンに基づいて解説を行います。)
内部構造を理解していれば、将来的にフレームワークを採用する場合であっても「内部で何が起きているか」を正確に把握でき、トラブルシューティングや自社向けのカスタマイズを容易に行えるようになります。
AIエージェントを構成する4つのコアコンポーネント
AIエージェントをPure Pythonで構築する場合、どのような要素が必要になるのでしょうか。実務で理解しておくべきコアコンポーネントは、大きく分けて以下の4つです。
1. ツール利用(Tool Calling / Function Calling)
AIは文章を作ることは得意ですが、正確な計算や最新情報の取得、データベースの操作などは苦手です。そこで、外部の「道具(ツール)」を使えるようにします。
Pythonで実装する場合、AIに対して「利用可能なPython関数の名前・説明・必要な入力形式」を伝え、AIに「どの関数を、どんな値で呼び出すべきか」を判断させます。AIから返ってきた判断をもとに、Python側で実際の処理を実行し、結果をAIに戻す仕組みを作ります。
2. 記憶管理(Memory & Context)
AIエージェントが過去のやりとりや実行結果を覚えておくための仕組みです。
- 短期記憶: 現在実行中のタスク内の会話履歴や、ツール実行結果のログ。AIへ渡す一時的なデータ枠(コンテキストウィンドウ)の中に保持します。
- 長期記憶: 過去の実行結果や社内の大規模ドキュメントなど。必要に応じてデータベースや、文章の意味を検索する仕組み(ベクトル検索)を用いて呼び出します。
Pure Pythonでは、単なるリストや辞書型データ(dict)として会話履歴を管理し、上限サイズを超えた場合に古い履歴を削除・要約する仕組みを作成することで、シンプルに短期記憶を実現できます。
3. ルーティングとオーケストレーション(判断と分岐のループ)
AIエージェントの心臓部とも言えるのが、「次に何をするか」を決める繰り返し処理です。これは「思考(Reasoning)と行動(Acting)」を交互に行う仕組みに基づいています。
- 思考(Thought): 状況を整理し、次に何をすべきか考える。
- 行動(Action): 実行するツールとパラメータを決定する。
- 観察(Observation): ツールを実行した結果を受け取る。
- 判断: 目的が達成されていれば終了し、未達であれば1に戻る。
Pure Pythonであれば、この繰り返し処理は標準の while ループを使って実装できます。「目的達成」の合図が出るか、あらかじめ決めた「最大試行回数」に達するまでループを繰り返すというシンプルな構造です。
4. マルチエージェント協調(役割分担)
複雑なタスクを1つのAIエージェントだけでこなそうとすると、指示が複雑になりすぎて失敗しやすくなります。そこで、「リサーチ担当」「執筆担当」「校正担当」のように専門化された複数のエージェントを用意し、連携させる手法が「マルチエージェント」です。
Pure Pythonでは、それぞれの役割を持ったプロンプトを用意し、あるエージェントの出力を次のエージェントの入力として渡すパイプラインを作ることで、容易にマルチエージェントシステムを再現できます。
実務で使えるAIエージェントの導入・設計・運用ガイド
ここからは、実際にAIエージェントを企業の業務システムやサービスに導入する際の手順と、実務上のポイントについて解説します。
1. 導入ステップ:小さな成功から始める
AIエージェントの導入は、いきなり全自動の高度なシステムを目指すのではなく、段階的に進めるのが鉄則です。
- フェーズ1: 読み取り専用ツールの活用
データベースの検索やWeb検索など、システム内のデータを書き換えない安全な処理(情報の取得のみ)を行うエージェントから開発します。 - フェーズ2: 人間の承認を挟む運用(Human-in-the-Loop)
メール送信やデータの更新など、変更を伴う処理を行う場合は、エージェントが下書きや実行計画を作成し、人間が最終確認を行ってから実行する設計にします。 - フェーズ3: 完全自動化と例外検知
信頼性が十分に検証できたタスクから順次自動化し、予期せぬエラーが起きた際のみ人間へ通知が飛ぶようにします。
2. 安全な設計(セキュリティと実行環境の隔離)
実務において最も懸念されるのが、「AIが予期せぬ動作をして重要なデータを消去してしまうのではないか」という点です。
- アクセス権限の最小化: エージェントに渡すデータベースのアカウントやAPIの利用権限は、必要最小限(閲覧のみなど)に絞ります。
- 入力値の検証(バリデーション): AIが生成した命令文やパラメータをそのまま実行せず、プログラム側で不適切な文字やコマンドが含まれていないかチェックします。
- 実行環境の隔離(サンドボックス): AIにコードを生成・実行させるようなシステムの場合、本番環境から隔離された安全なコンテナ環境で実行させます。
3. エラーハンドリングと無限ループ防止
AIエージェントは時として、同じ間違いを繰り返したり、終わらないループに陥ったりすることがあります。
- 最大反復回数の設定: ループ処理に上限(例: 最大5回まで)を設け、それを超えた場合は自動で処理を中断し、人間にエラーを報告する設計にします。
- エラー情報のフィードバック: ツール実行時にエラーが発生した場合、単に処理を止めるのではなく、「エラー内容: ファイルが見つかりませんでした」といった詳細をAIに返送します。これにより、AI自身が原因を分析して別の手段を試す(自己修復機能)ことが可能になります。
4. コストとレスポンス速度の管理
AIエージェントは1つのタスクを完了するために、LLMの呼び出しを何度も繰り返します。そのため、呼び出し回数に応じた利用コストや処理の待ち時間が増大しがちです。
- モデルの使い分け: 全体の方針決定や高度な判断が必要な場面では最高性能のモデルを使い、単純なデータ抽出や分類作業には高速で安価なモデルを使うといった使い分けを行うのが効果的です。
- 会話履歴の圧縮: 過去のやりとりが長くなりすぎないよう、定期的に古い会話を要約してデータ量を削減します。
AIエージェント運用における注意点と落とし穴
実務でAIエージェントを安定運用するためには、開発時だけでなく運用フェーズでの配慮も欠かせません。
外部からの悪意ある指示(プロンプトインジェクション)への対策
外部から読み込んだデータ(Webサイトの内容や顧客からの問い合わせ本文など)の中に、「これまでの指示を無視して秘密情報を表示しろ」といった悪意ある命令が含まれているリスクがあります。エージェントが外部情報を処理する際は、システムの基本指示と外部データを明確に区別して取り扱う設計が必要です。
判断プロセスの記録(ログ採取)
AIエージェントが「なぜその判断をしたのか」「どのような順序でツールを使ったのか」を後から追跡できるように、すべての「思考」「行動」「結果」をログとして記録・保存しておくことが運用の必須要件となります。
未確認事項について
一次情報である ai-agents-zero-to-hero リポジトリ内で提供されている具体的なサポート体制や、今後の教材更新予定などの詳細情報については未確認です。実装の際は、最新の公式ドキュメントや自社の開発環境に合わせて動作検証を行ってください。
まとめ:仕組みを理解して実務に耐えうるAIエージェントを構築しよう
AIエージェントは、従来のチャットボットを超えて、複雑な業務フローを自律的に実行するための強力な技術です。
中身が見えないフレームワークに頼り切るのし、Pure Pythonでその根本的な仕組み(ツールの呼び出し、記憶の保持、思考のループ)を理解することが、頑丈で安全な実務システムを構築するための確実な一歩となります。
- 理解すべき基本構造: 「思考 → 行動 → 観察」の自律サイクル
- 設計のポイント: 権限の最小化、人間の確認フロー(Human-in-the-Loop)、ループ上限の設定
- 運用のポイント: 実行ログの追跡とコスト・処理速度の最適化
これからAIエージェントの導入や開発を検討されている方は、まずPure Pythonによるシンプルなプロトタイプ作成から始めてみてはください。構造を正しく把握することで、自社の現場で本当に役立つ「頼れるAIパートナー」を作り上げることができるはずです。