日常業務でChatGPTやClaudeなどの生成AIを活用する機会が増えてきました。Webサイトの文章作成や、Python・HTMLといった一般的なプログラミングコードの生成であれば、AIは驚くほど高い精度で回答してくれます。
しかし、次のような壁にぶつかった経験はないでしょうか。
「自社の独自システムで使っている設定ファイルを出力させたいが、AIが架空の文法を作り出してしまう」
「CADデータや独自の記法など、マイナーな形式を指定すると途端に支障が出る」
「AIに指示(プロンプト)を出しても、複雑な構造のデータになると形式が崩れてしまう」
一般的な開発言語とは異なり、マイナーな領域や特殊な形式(ドメイン固有の言語)をAIに正しく扱わせることは、非常に難易度が高いとされています。
そんな中、海外の技術コミュニティ「Hacker News」で注目を集めたのが、AIにレゴブロックの3Dモデルを組み立てるコードを生成させるオープンソースプロジェクト「ldraw-nova」です。
レゴのモデルを表現する「LDraw(エルドロー)」という言語は、ブロックの型番や配置座標、回転行列などをテキストで細かく記述する、いわば「レゴ界のアセンブリ言語(コンピュータが直接理解するような基礎的で細かい命令)」です。AIにとって学習データが少ないこの特殊な言語を、どのようにしてAIに正しく生成させるのでしょうか。
本記事では、オープンソースの「ldraw-nova」の取り組みを題材に、AIに目的通りの成果物を出力させる技術である「プロンプトエンジニアリング」の基礎から実務への応用、導入・設計・運用のポイントまでをわかりやすく解説します。
なぜ「レゴ生成AI」がプロンプトエンジニアリングの最良の教科書なのか
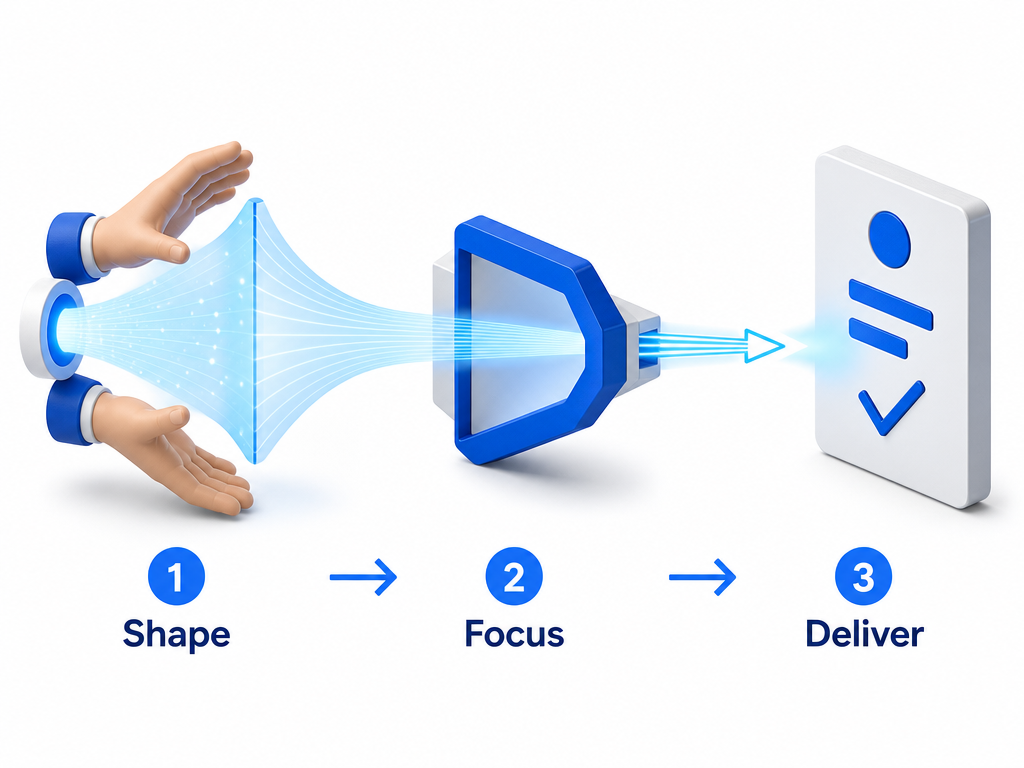
まずは、今回の題材となる「LDraw」と「ldraw-nova」について整理し、なぜこれが私たちの日常業務やシステム開発に役立つプロンプトエンジニアリングの良質なケーススタディになるのかを紐解きます。
LDrawとは何か?AIにとっての「難関」の理由
LDraw(エルドロー)とは、レゴブロックの3Dモデルをテキストデータで表現するためのオープンな規格です。例えば、ひとつのブロックを配置するだけでも、以下のような一行のコードが必要になります。
- どのパーツを使うか(パーツ番号)
- どの色にするか(カラーコード)
- 空間のどこに置くか(X, Y, Z軸の立体座標)
- どの向きに回転させるか(3×3の回転行列)
プログラミングに詳しくない方でも、「直感的に『赤いブロックを上に乗せる』と書くのではなく、細かい数値と記号の羅列で指定しなければならない仕組み」だとイメージしていただければ十分です。このような低レイヤー(コンピュータに近い細かい命令)の言語は、人間にとっても記述が難しいだけでなく、生成AI(LLM:大規模言語モデル)にとっても大きな課題となります。
その理由は主に2つあります。
- 学習データの少なさ
PythonやJavaScriptのようなメジャーな言語に比べ、インターネット上に存在するLDrawコードの量は限られています。そのため、AIが「なんとなくの雰囲気」で生成することができません。 - 形式の厳密性と空間認識の難しさ
座標や回転の計算が1数値でもズレると、ブロック同士が空間上でめり込んだり、宙に浮いたりしてしまいます。AIは本質的に文章の「次に来る確率が高い単語」を予測する仕組みであるため、正確な3D空間の計算や厳密な構文チェックは苦手分野です。
「ldraw-nova」が示した課題解決のアプローチ
この困難な課題に対し、「ldraw-nova」というプロジェクトは、ChatGPTやClaudeといった最先端の生成AIを活用し、ユーザーが自然な言葉(「〇〇の形のレゴを作って」など)を入力するだけで、正しく組み上がるLDrawコードを生成させる実験を行っています。
未知の言語や特殊なフォーマットであっても、プロンプトエンジニアリング(AIに対する指示の出し方や枠組みの工夫)を適切に設計すれば、AIの能力を最大限に引き出せることをこのプロジェクトは証明しています。
これは、私たちが実務で「社内独自のフォーマットをAIに出力させたい」「複雑なJSONデータを破綻なく生成させたい」と考えたときに、そのまま応用できる貴重な知見の宝庫なのです。
ldraw-novaの取り組みから解き明かすプロンプトエンジニアリングの設計手法
では、AIに特殊な言語や複雑なデータを正しく出力させるためには、具体的にどのようなプロンプトエンジニアリングの手法が必要なのでしょうか。実務に応用できる4つのステップに分けて解説します。
ステップ1:コンテキスト(文脈)とルール(制約)の徹底的な与え込み
AIに指示を出す際、「LDrawで車を作ってください」とだけ伝えても、まともなコードは返ってきません。AIが前提知識を持っていない場合は、人間側が事前に「文脈」と「ルール」を定義してプロンプトに組み込む必要があります。
実務における設計例:
- 役割の定義: 「あなたはLDraw言語のエキスパートであり、構造的に安定したレゴモデルのコードを作成するエンジニアです」とAIの立ち位置を指定します。
- 文法の基本ルールの明記: LDrawの命令記述フォーマット(1行目にパーツ種別、2行目に座標…など)の基本仕様をプロンプト内に直接書き込みます。
- 制約条件の設定: 「存在しないパーツ番号は使わない」「パーツ同士がめり込まないように座標を計算する」といった禁止事項や遵守事項を明確にします。
専門用語を使わずに言えば、「新入社員にマニュアルを渡さずにいきなり仕事を頼むのし、業務のルールブックとチェックリストをあらかじめ手渡してから作業を依頼する」というアプローチです。
ステップ2:Few-shotプロンプティング(具体例の提示)
言葉でルールを説明するだけでなく、「正しい出力の具体例」を数パターン見せることが非常に有効です。これをプロンプトエンジニアリングでは「Few-shot(フューショット)プロンプティング」と呼びます。
例えば、以下のような対のサンプルをプロンプトに含めます。
入力例: 「2×4の赤いブロックの上に、2×2の黄色いブロックを中央に乗せる」
出力例:
1 4 0 0 0 1 0 0 0 1 0 0 0 1 3001.dat
1 14 0 24 0 1 0 0 0 1 0 0 0 1 3003.dat
このように、「こういうリクエストが来たら、こういう形式で返しなさい」という手本をいくつか示すことで、AIは形式のズレや文法エラーを劇的に減らすことができます。実務で独自フォーマットのCSVやJSON、設定ファイルを出力させる際にも、手本となるサンプルデータを1〜3個プロンプトに貼り付けるだけで精度が見違えるほど向上します。
ステップ3:Chain-of-Thought(思考過程の出力)
複雑な3D配置やロジックが必要な作業をAIに一発で出力させようとすると、AIは計算ミスを起こしやすくなります。そこで、「いきなりコードを書くのではなく、順番に考えてから出力しなさい」という指示を出します。これを「Chain-of-Thought(思考の連鎖)」と呼びます。
具体的には、プロンプト内で次のようなステップを踏ませます。
- 作成したいオブジェクトの全体構造を言葉で分解する(例: 「土台」「車輪」「ボディ」に分ける)
- 各パーツの相対的な位置関係と必要なパーツ番号をリストアップする
- 最後に、確定した数値をもとにLDrawコードを生成する
「考えてから書く」という人間と同じステップを踏ませることで、複雑な空間計算や論理構造の破綻を防ぐことができます。
ステップ4:パイプライン化と自動フィードバック(プログラムによる検証)
プロンプトの工夫だけで100%完璧なコードが出力されるとは限りません。特にLDrawのような厳密な言語では、文法チェックプログラム(構文解析器)との連携が欠かせません。
「ldraw-nova」のようなシステム設計において重要なのは、「AIの出力→外部ツールでの自動チェック→エラーがあればAIにフィードバックして再生成」という自動化の仕組み(パイプライン)を作ることです。
- AIがコードを生成する
- プログラムがそのコードを読み込み、文法エラーやパーツの衝突がないか検証する
- エラーがあった場合、そのエラー内容(例: 「◯行目のパーツIDが存在しません」)をプロンプトに追加してAIに再送信する
- AIがエラーを修正したコードを再出力する
このように、AI単体で完結させるのし、既存のシステムや検証用プログラムと組み合わせる「フィードバックループ」を設計することが、実務運用での成功の鍵となります。
実務に応用する際の注意点と限界
AIを用いた特殊コード生成やプロンプトエンジニアリングを実際の業務やプロダクトに導入する際には、いくつか注意すべき限界やリスクがあります。
1. コンテキストウィンドウ(記憶容量)とトークンコストの壁
プロンプトに詳細なマニュアルやサンプルコード、パーツリストを詰め込みすぎると、AIが一度に読み込める文字数の上限(コンテキストウィンドウ)に達してしまいます。
また、文字数が増えるほどAIの利用料金(トークン費用)が高くなり、応答速度も遅くなります。必要な情報だけを厳選してプロンプトに含める、あるいは関連する情報だけをデータベースから検索して動的にプロンプトに挿入する技術(RAG:検索拡張生成)の検討が必要です。
2. ハルシネーション(嘘の出力)の完全な抑制は困難
AIは時に、存在しない架空のパーツ番号や、文法的に間違った命令文をさも正しいかのように出力します(ハルシネーション現象)。
どれだけプロンプトエンジニアリングを極めても、AIの確率的な挙動を100%制御することはできません。そのため、「AIが生成したデータは必ずプログラムによる構文チェックを通す」「重要データは人間が目視確認する」という前提のシステム設計を行ってください。
3. 一次情報に関する未確認事項
なお、今回の題材であるオープンソースプロジェクト「ldraw-nova」のGitHubリポジトリ(anteloc/ldraw-nova)について、プロジェクトの概要やLDraw言語を用いた基本コンセプトは確認されていますが、具体的なPythonコードの実装詳細や最新のベンチマーク結果、対応しているAIモデルのバージョン一覧といった内部仕様の全容については、リポジトリの個別のコード差分まで精読していないため未確認です。実際にコードを利用・カスタマイズされる際は、公式リポジトリのREADMEおよびソースコードを直接ご確認ください。
まとめ:特殊領域×プロンプトエンジニアリングで広がるAIの可能性
「Show HN: Made an open-source Lego AI generator(レゴ生成AIを作った)」という投稿は、単なる面白い電子工作や趣味の実験にとどまらず、プロンプトエンジニアリングの本質を突いた素晴らしい事例です。
本記事のポイントを改めて整理します。
- 特殊な言語やフォーマット: メジャーでない言語(LDrawなど)をAIに生成させるには、AI単体の知識に頼らない設計が必要。
- コンテキストと制約の明確化: 役割、文法ルール、禁止事項をプロンプトで厳密に提示する。
- Few-shotの活用: 具体的な入力と出力のサンプルを手本として見せることで、出力形式を安定させる。
- 思考の連鎖(Chain-of-Thought): 段階的に考えさせることで、複雑な計算や構造化のミスを減らす。
- 自動検証の仕組み: プログラムによるチェックとAIへのフィードバックループ(修正指示)を組み込む。
自社のビジネスにおいても、「AIには扱えない」とあきらめていた社内独自データや複雑な設定ファイルの生成処理がないでしょうか。今回紹介したプロンプトエンジニアリングの手法やパイプライン設計を取り入れることで、業務自動化の可能性は大きく広がるはずです。
まずは手元の小さなフォーマット定義と具体例(Few-shot)をAIに与えるところから、実践的なプロンプト設計を始めてみてはください。