近年、ソフトウェア開発の現場では、プログラミングやシステム構築を自動化・支援する「AIエージェント」の活用が急速に進んでいます。AIエージェントとは、人間の指示を受けて自律的に考え、プログラムコードの記述やエラーの修正、テストの実行といった一連の作業を進めてくれる賢いシステムのことです。
しかし、実際の現場でAIエージェントを導入しようとすると、必ず大きな壁にぶつかります。それは「一番頭が良い最先端のAIモデルを使うと、費用があまりにも高くなり、応答速度も遅くなる」という問題です。だからといって、安くて速い小型のAIモデルを使うと、複雑なプログラミングの処理で間違ったコードを出力してしまうというトレードオフが生じます。
「結局、高価な最新AIモデルを1つ選んで使い続けるしかないのか?」
この課題に対する革新的な解決策として世界中のエンジニアから注目を集めているのが、複数のAIモデルを賢く使い分ける「モデルルーティング(Model Routing)」という技術です。
今回取り上げる Hacker News の話題(Show HN: Open-source model routing for coding agents at Astra-level performance)では、コーディングに特化したAIエージェントにおいて、単一の最高峰AIモデルに頼るのではなく、複数のモデルを組み合わせる(アンサンブルする)仕組みをオープンソースとして構築し、業界最高峰の性能(Astraレベル)を達成した取り組みが紹介されています。
この記事では、専門知識がない方や実務への導入を検討している方に向けて、モデルルーティングの基本概念から、なぜ単一モデルを超える成果を出せるのか、そして実際のAIエージェント設計・運用で押さえるべきポイントまでを分かりやすく解説します。
1. なぜ「1つのモデル」では限界があるのか?モデルルーティングの基礎知識
AIエージェントとAIモデルの決定的な違い
まず、言葉の整理をしておきましょう。「AIモデル」とは、GPT-4やClaudeなどのように、入力を受け取って文章やコードを出力する計算エンジンそのものを指します。
一方で「AIエージェント」とは、そのAIモデルを「脳」として組み込み、目標を達成するために「指示の解釈 → 処理の実行 → 結果の確認 → 修正」というサイクルを自律的に繰り返すシステム全体を指します。
例えば、AIエージェントに「このWebサイトのログイン機能を実装して」と頼むと、エージェントは自ら必要なファイルを読み込み、コードを書き、テストを実行してエラーが出たら修正する、という一連の業務をこなします。
「モデルルーティング」とは何か?
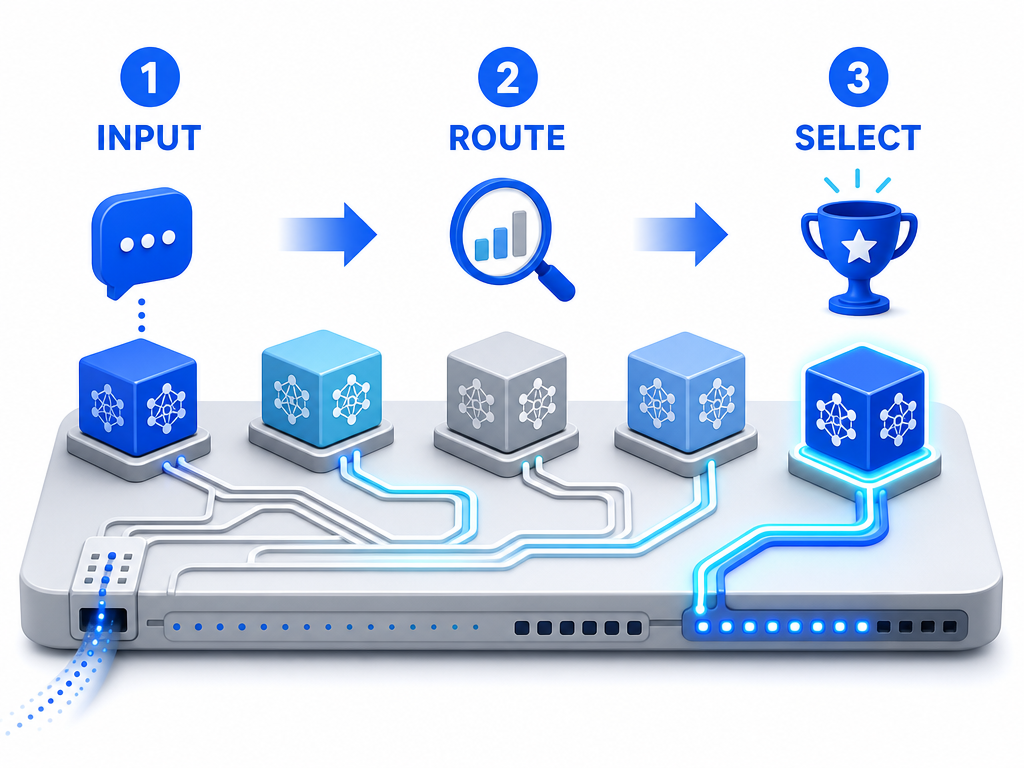
システム開発における「ルーティング」とは、「届いたデータを適切な宛先に振り分けること」を意味します。つまり「モデルルーティング」とは、ユーザーやエージェントから依頼された作業(タスク)の内容に応じて、最適なAIモデルに処理を自動で振り分ける仕組みのことです。
人間の会社組織に例えてみましょう。
- 単一モデルの運用:すべての仕事(簡単なメール返信から、難解な契約書の作成、新事業の戦略立案まで)を、最も給料が高い最高幹部1人に頼み続ける状態です。当然、人件費(コスト)は跳ね上がり、幹部のもとに仕事が集中して返事が遅くなります。
- モデルルーティング:受付係(ルーター)がいて、簡単な定型作業は新人スタッフ(軽量・高速・低コストなAIモデル)に振り分け、高度な判断が必要な仕事だけを幹部(高性能・高価格なAIモデル)に回す仕組みです。
このように業務を適切に分担させることで、組織全体のスピードと品質を引き上げつつ、全体的な人件費(コスト)を劇的に下げることができます。
アンサンブル(組み合わせ)が単一モデルを超える理由
今回話題となった取り組みの核心は、「アンサンブル(複数のものを組み合わせる手法)」にあります。
一見すると「一番賢い最新AIモデル1つの方が、どんなタスクでも一番正解を出せるのでは?」と思われがちです。しかし、プログラミング作業には多種多様なステップが存在します。
- ドキュメントの読み込みや要約(コンテキスト処理が得意なモデルが有利)
- 単純なコード変換やタイポ修正(高速で軽量なモデルで十分)
- 複雑なアルゴリズムや設計の検討(思考力の高い大型モデルが必要)
- テストコードの機械的な生成(特定の命令に忠実なモデルが得意)
それぞれのタスクに対して「最も得意で、かつ最も効率的なモデル」を選び出して処理を連携させることで、単一の最高峰モデルを1つだけで動かすよりも、全体としての正確さ(パフォーマンス)、処理スピード、そしてコストパフォーマンスのすべてで上回ることが可能になります。
2. コーディングAIエージェントにおけるモデルルーティングの設計・仕組み
実際にコーディング用のAIエージェントでモデルルーティングを実現するためには、どのようなアーキテクチャ(構造)が必要になるのでしょうか。ここでは技術的な概念を平易に紐解いていきます。
タスクの自動分類(振り分けロジック)
ルーティングの心臓部となるのが「依頼されたタスクの難易度や種類をどのように判断するか」という分類器(ルーター)です。
主な判断基準には以下のようなものがあります。
- プロンプト(指示文)の複雑さ:入力された文章の長さや、含まれる指示の数。
- 要求される処理の種類:「新規機能の設計」なのか、「エラーログの解析」なのか、「関数のコメント記述」なのか。
- 対象コードの規模:数行の修正なのか、複数ファイルにまたがる大きな改修なのか。
この分類自体を、超高速で動作するごく小型のAIモデル(またはルールベースのプログラム)に行わせます。分類に時間がかかってしまっては本末転倒なため、「一瞬で難易度を見極める仕組み」を作ることが成功の鍵となります。
コストと応答速度(レイテンシ)の最適化
AIの利用料金は、一般的に「扱う文字数(トークン数)」に応じて決まります。また、AIが返答を返すまでの待ち時間(レイテンシ)は、モデルのサイズが大きいほど長くなります。
モデルルーティングを導入すると、全体の処理のうち7割から8割程度の「比較的簡単なタスク」を、1回あたりのコストが数十分の1から数百分の1で済む軽量モデルに流すことができます。
その結果、AIエージェント全体の運用費用を劇的に削減しながら、ユーザーへのレスポンス速度(体感速度)を大幅に向上させることが可能になります。高価格なモデルは、真に困難なプログラミングの難局(2割程度のタスク)でのみ呼び出されるため、リソースの無駄遣いがゼロになります。
(注:なお、一次情報元である Hacker News 投稿記事における独自のルーティングアルゴリズムの具体的なコード実装や、ベンチマークテストの厳密な詳細数値については、参照データソースの構成上、未確認です。)
3. 実務導入での設計・運用ガイドと注意点
モデルルーティングは非常に魅力的なアプローチですが、実務のシステムや開発プロセスに組み込む際には、いくつか気を付けるべき注意点があります。失敗を防ぐための設計ガイドラインを解説します。
① ルーター自体の「オーバーヘッド」に注意する
ルーティングを行うということは、本処理(コードを書くこと)の前に「どのモデルに頼むか決める」という追加のステップが入ることを意味します。この処理にかかる時間やコストを「オーバーヘッド」と呼びます。
もしルーターの判断処理が重すぎて回答までに何秒もかかってしまっては、軽量モデルを使うメリットが相殺されてしまいます。ルーターには極力シンプルで高速な仕組み(軽量な分類用モデルや明確な判定ルール)を採用することが推奨されます。
② フォールバック(予備・自動切り替え)の設計
軽量モデルにタスクを振り分けたものの、AIが正しくコードを生成できずエラーになってしまうケースがあります。
このとき、システムが止まってしまっては使いものになりません。実務設計では、以下のような「フォールバック(不具合時の切り替え手順)」をあらかじめ組み込んでおくことが必須です。
- まず軽量モデルAに処理を頼む。
- 出力されたコードのテストを実行し、失敗した場合や構文エラーが出た場合を検知する。
- 自動的に上位の高性能モデルBへタスクを昇格(再依頼)させる。
この安全網があることで、品質を担保しつつ平均コストを最小限に抑えることができます。
③ コンテキスト(文脈)の引き継ぎと状態管理
AIエージェントが複数のモデルを行き来しながら作業を進める場合、「それまでの会話や開発の文脈(コンテキスト)」をどのように共有するかが重要になります。
モデルによって受け取れる文字数の上限(コンテキストウィンドウ)や、指示の理解しやすいフォーマットが異なるため、エージェント側で履歴を適切に整形し、どのモデルに渡しても正しく状況が伝わるデータ構造を用意する必要があります。
④ APIのレート制限(利用制限)と障害への耐性
特定のAIサービス(提供元)だけに依存していると、そのサービスのサーバーが落ちたり、利用制限(レートリミット)に達したりした瞬間にAIエージェント全体が停止してしまいます。
モデルルーティングの副次的な大きなメリットは、マルチクラウド(複数のAI提供企業)のモデルを組み込める点です。あるAIサービスが不調な場合は、自動的に別の会社のモデルへルーティングするよう設計しておくことで、極めて止めにくい堅牢なシステムを構築できます。
4. まとめ
AI技術の進化スピードは凄まじく、毎月のように新しい「最強モデル」が登場しています。しかし、そのたびにシステム全体を一から作り直したり、単一の最高額モデルを使い続けたりすることは、実務における費用対効果や運用の観点から現実的ではなくなりつつあります。
今回ご紹介した「モデルルーティング」という手法は、今後のAIエージェント活用における大きなトレンドとなるでしょう。
- 得意分野の組み合わせ:複数のモデルをチームのように機能させ、単一モデル以上の成果を出す。
- コストと速度の最適化:日常的なタスクは軽量モデル、難問だけを最高峰モデルに振ることでコスパを最大化。
- 実務での工夫:ルーターの高速化、エラー時の自動切り替え(フォールバック)、文脈の保持が成功の鍵。
「どのAIモデルを使うか」という1点突破の視点から脱却し、「複数のモデルをいかに賢く交通整理して組み合わせるか」というAIエージェントのアーキテクチャ設計に目を向けることこそが、実務で成果を出し続けるための最も重要なアプローチです。
ぜひ皆さんのプロジェクトでも、モデルルーティングの考え方を取り入れた効率的なAIエージェント活用を検討してみてください。